
前回の記事では、複数バイトのデータをメモリ上に並べる順番を表すエンディアンについて解説しました。
そこで何度も登場したのが、uint8_t、uint16_t、uint32_tといったデータ型です。
しかし、C/C++にはintやchar、floatなど、ほかにも多くのデータ型があります。
「intは何バイトなのか?」「uint8_tとunsigned charは何が違うのか?」「なぜ組み込み開発ではuint32_tのような型をよく使うのか?」と疑問に思うこともあるでしょう。
今回は、C/C++のデータ型とデータサイズについて、組み込み開発で特に重要なポイントを中心に解説します。
データ型とは?
データ型とは、変数がどのような種類のデータを扱うのかを表すものです。
たとえば次のプログラムでは、それぞれ異なる型の変数を宣言しています。
int count = 10;
float temperature = 23.5;
char command = 'A';
bool enabled = true;
それぞれの型には、扱える値の種類や範囲、メモリ上で必要になるサイズなどの違いがあります。
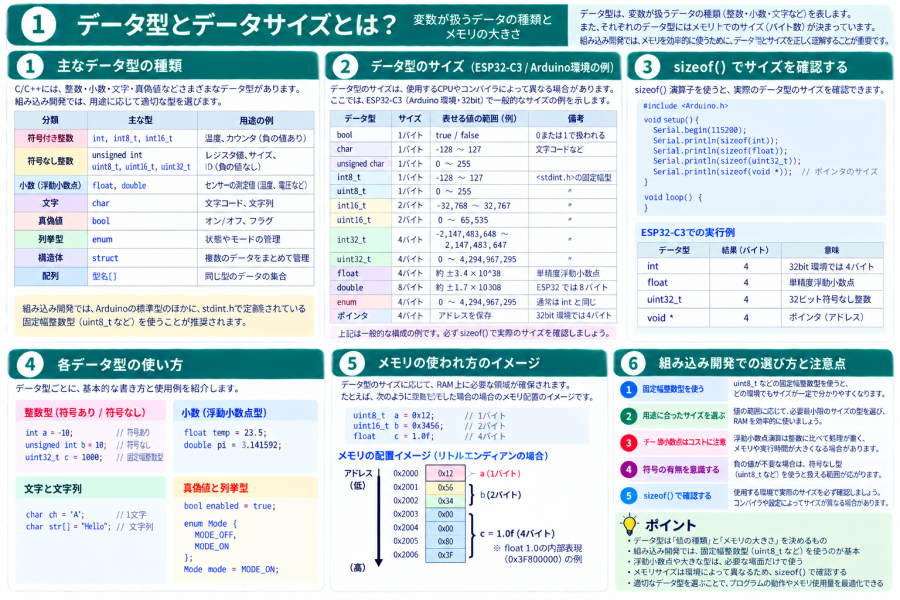
なぜデータ型が必要なの?
マイコンのメモリに保存されているものは、最終的には0と1の並びです。
たとえば同じ32ビットのデータでも、それを整数として解釈するのか、浮動小数点数として解釈するのかによって意味が変わります。
データ型を指定することで、コンパイラはそのデータをどのように扱えばよいのか判断できます。
- どれくらいのメモリ領域が必要なのか
- 整数なのか小数なのか
- 負の値を扱うのか
- どのような演算を行うのか
- どの範囲の値を表現できるのか
データサイズとは?
データサイズとは、そのデータを保存するために必要なメモリの大きさです。
たとえばuint8_tは8ビット、つまり1バイトの整数型です。
8 bit  = 1 byte
16 bit = 2 byte
32 bit = 4 byte
64 bit = 8 byte
データサイズが大きくなれば、一般により広い範囲の値を表現できる一方、その分だけメモリも使用します。
C/C++の代表的なデータ型
C/C++にはさまざまなデータ型があります。
| 分類 | 代表的な型 | 用途 |
|---|---|---|
| 整数 | char、short、int、long | 整数値 |
| 符号なし整数 | unsigned intなど | 0以上の整数 |
| 固定幅整数 | uint8_t、uint16_t、uint32_t | ビット数を明確にした整数 |
| 浮動小数点 | float、double | 小数 |
| 真偽値 | bool | true / false |
| 列挙型 | enum | 状態やモード |
intは何バイト?
intは整数を扱う基本的な型です。
int count = 100;ここで注意したいのは、C/C++の規格上、intが必ず4バイトとは限らないことです。
型のサイズはCPUアーキテクチャやコンパイラなどの実装環境によって異なる場合があります。
ESP32-C3の一般的なArduino開発環境ではintは4バイトですが、別のマイコンでも同じとは限りません。
実際のサイズはsizeof()で確認するのが確実です。
sizeof()でデータサイズを確認する
C/C++には、型や変数のサイズを調べるためのsizeof演算子があります。
Serial.println(sizeof(char));
Serial.println(sizeof(int));
Serial.println(sizeof(float));
Serial.println(sizeof(double));
Serial.println(sizeof(uint32_t));sizeofが返す値の単位はバイトです。
たとえば、
sizeof(uint32_t)が4なら、その環境ではuint32_tが4バイトであることを意味します。
符号あり整数と符号なし整数
整数型には、符号あり(signed)と符号なし(unsigned)があります。
符号あり整数では負の値を扱えます。
int temperature = -10;一方、符号なし整数は0以上の値だけを扱います。
unsigned int count = 100;同じビット数なら、符号なし整数は負の値を表現する必要がないため、その分だけ正の方向へ広い範囲を表現できます。
8ビット整数の値の範囲
8ビットの整数を例に考えてみましょう。
uint8_tは符号なし8ビット整数なので、表現できる値は次の範囲です。
0 ~ 255
8ビットでは28 = 256通りの組み合わせを表現できるためです。
一方、一般的な2の補数表現を用いるint8_tでは、
-128 ~ 127
を表現できます。
固定幅整数型とは?
組み込み開発で特に重要なのが、固定幅整数型です。
代表的なものには次があります。
| 型 | ビット数 | 代表的な範囲 |
|---|---|---|
int8_t | 8bit | -128 ~ 127 |
uint8_t | 8bit | 0 ~ 255 |
int16_t | 16bit | -32,768 ~ 32,767 |
uint16_t | 16bit | 0 ~ 65,535 |
int32_t | 32bit | -2,147,483,648 ~ 2,147,483,647 |
uint32_t | 32bit | 0 ~ 4,294,967,295 |
int64_t | 64bit | 符号あり64bit整数 |
uint64_t | 64bit | 符号なし64bit整数 |
これらは<stdint.h>で定義されており、Arduino環境でも利用できます。
なぜ組み込み開発ではuint8_tなどを使うの?
組み込み開発では、データのビット数そのものに意味があることが多いためです。
たとえばI2Cで1バイト受信したデータを保存する場合を考えます。
uint8_t data;uint8_tなら「符号なし8ビットの値」であることがコードからすぐに分かります。
同様に、16ビットレジスタなら、
uint16_t registerValue;32ビットのカウンタなら、
uint32_t counter;のように、データ幅を明確にできます。
charとは?
charは文字を扱うときによく使用される整数型です。
char command = 'A';C/C++では文字も内部的には数値として扱われます。
また、C/C++ではsizeof(char)は定義上必ず1です。ただし1バイトが何ビットかは規格上固定ではなく、組み込み開発で一般的な環境では8ビットです。
文字列とchar配列
C言語形式の文字列は、charの配列として表現できます。
char message[] = "Hello";実際には文字列の最後に終端を示すヌル文字'\0'が入ります。
'H' 'e' 'l' 'l' 'o' '\0'
そのため、この配列には6文字分の領域が必要です。
floatとは?
floatは小数を扱うための浮動小数点型です。
float temperature = 23.5f;ESP32-C3の一般的な開発環境ではfloatは4バイトで、IEEE 754の単精度浮動小数点形式が使用されます。
温度、湿度、加速度、電圧など、小数を含む測定値を扱う場面でよく使用されます。
doubleとは?
doubleも小数を扱う浮動小数点型です。
double value = 3.141592653589793;ESP32-C3の一般的なツールチェーンではdoubleは8バイトで、floatより高い精度を扱えます。
ただし、マイコンやコンパイラによって仕様が異なる可能性があるため、移植性が重要な場合はsizeof()や開発環境の仕様を確認しましょう。
整数と浮動小数点数はメモリの使い方が違う
同じ4バイトであっても、uint32_tとfloatではビット列の意味が異なります。
uint32_tでは32ビットを整数として解釈します。
一方、一般的なfloatでは符号部・指数部・仮数部などに分けて浮動小数点数を表現します。
つまり、同じサイズだから同じデータとして扱えるわけではありません。
boolとは?
boolは真偽値を表す型です。
bool enabled = true;値としてtrueまたはfalseを扱います。
LEDのON/OFF状態や、通信接続の有無、処理を実行するかどうかといったフラグに便利です。
boolの実際のサイズについても、必要ならsizeof(bool)で確認できます。
enum(列挙型)とは?
状態やモードを表現するときには、enum(列挙型)が便利です。
enum MotorMode {
    MOTOR_STOP,
    MOTOR_FORWARD,
    MOTOR_REVERSE
};

MotorMode mode = MOTOR_STOP;
単純に0、1、2などの数値を使うよりも、コードの意味が分かりやすくなります。
ただし、列挙型のサイズについては言語仕様やコンパイラ設定なども関係するため、通信フォーマットなどでサイズを固定したい場合には注意が必要です。
ポインタにもサイズがある
以前学習したポインタも、メモリ上ではデータとして保存されています。
int *p;ポインタにはメモリアドレスを保存するための領域が必要です。
ポインタのサイズは環境によって異なります。
Serial.println(sizeof(void *));ESP32-C3の一般的な32ビット環境では、ポインタは4バイトです。
ポインタについては「ポインタとは?アドレス・&・*の意味を初心者向けに解説」で詳しく解説しています。
構造体にもサイズがある
構造体もメモリ上に配置されるため、当然サイズがあります。
struct SensorData {
    uint8_t id;
    uint32_t value;
};
ここで、
uint8_t  = 1バイト
uint32_t = 4バイト

合計 = 5バイト?
と思うかもしれません。
しかし実際には、CPUやコンパイラがデータを効率よく扱えるようにパディングが挿入され、5バイトより大きくなる場合があります。
Serial.println(sizeof(SensorData));実際のサイズはsizeof()で確認できます。
構造体については「構造体とは?C/C++のstructとメンバ・ポインタの使い方を初心者向けに解説」も確認してください。
データ型とエンディアンの関係
前回学習したエンディアンも、データサイズと密接に関係しています。
uint8_tは1バイトなので、バイトの並び順は問題になりません。
一方、uint32_tは4バイトです。
uint32_t value = 0x12345678;

4バイト
↓
12 34 56 78
この4バイトをメモリ上にどの順番で配置するかがエンディアンです。
詳しくは「エンディアンとは?ビッグエンディアンとリトルエンディアンの違いを初心者向けに解説」を参照してください。
オーバーフローとは?
データ型には表現できる値の範囲があります。
たとえばuint8_tで表現できる値は0~255です。
uint8_t value = 255;

value++;
符号なし整数では、このように最大値を超える演算を行うと2のビット幅を法として値が循環するため、この例では0になります。
これを知らずにカウンタなどを作ると、予想外の動作に見えることがあります。
なお、符号付き整数のオーバーフローはC/C++では符号なし整数と同じ扱いではありません。最大値を超えたら必ず最小値へ戻る、と考えてはいけません。
大きい型を使えばいいわけではない
「サイズが大きい型なら広い範囲を扱えるので、全部uint64_tにすればいいのでは?」と思うかもしれません。
しかし、必要以上に大きな型を使うと、用途やマイコンによっては次のような影響があります。
- RAM使用量が増える
- 配列を大量に確保すると差が大きくなる
- CPUがネイティブに扱いにくい幅では演算コストが増える場合がある
- 通信データ量が増える
- データが本来何ビット必要なのか分かりにくくなる
用途に合った型を選ぶことが重要です。
小さければいいわけでもない
反対に、「RAMを節約したいから全部uint8_tにする」という考え方も適切ではありません。
扱いたい値が255を超えるならuint8_tには入りません。
また、CPUによっては自然なワード幅の整数型の方が効率よく演算できる場合もあります。
値の範囲、メモリ、処理内容、通信仕様などを考えて型を選ぶことが大切です。
組み込み開発ではデータシートのビット幅を見る
組み込み開発では、接続するICやセンサーのデータシートにデータ幅が書かれています。
たとえば、
DEVICE_ID : 8bit
TEMP_DATA : 16bit
COUNTER   : 32bit
と定義されているなら、プログラム側でも、
uint8_t  deviceId;
uint16_t temperature;
uint32_t counter;
のようにデータ幅を合わせると、コードの意図が分かりやすくなります。
KUMITATE-C3でsizeof()を確認してみよう
KUMITATE-C3を使って、実際に各データ型のサイズを確認してみましょう。
void setup() {

    Serial.begin(115200);

    delay(1000);

    Serial.print("char      : ");
    Serial.println(sizeof(char));

    Serial.print("int       : ");
    Serial.println(sizeof(int));

    Serial.print("uint8_t   : ");
    Serial.println(sizeof(uint8_t));

    Serial.print("uint16_t  : ");
    Serial.println(sizeof(uint16_t));

    Serial.print("uint32_t  : ");
    Serial.println(sizeof(uint32_t));

    Serial.print("float     : ");
    Serial.println(sizeof(float));

    Serial.print("double    : ");
    Serial.println(sizeof(double));

    Serial.print("pointer   : ");
    Serial.println(sizeof(void *));
}

void loop() {
}
シリアルモニターに、それぞれの型が何バイトなのか表示されます。
「intは4バイトらしい」と暗記するだけでなく、実際の開発環境でsizeof()を使って確認する習慣を付けるとよいでしょう。
組み込み開発でのデータ型の選び方
データ型を選ぶときは、次の順番で考えると分かりやすくなります。
- 整数なのか小数なのか
- 負の値が必要なのか
- 必要な値の範囲はどこまでか
- データ幅が仕様で決められているか
- 通信やレジスタと対応する必要があるか
- メモリ使用量に制約があるか
たとえば、0~100%の値だけを保存するならuint8_tでも十分です。
一方、ミリ秒単位の長時間カウンタなら、より大きな整数型が必要になる場合があります。
これまで学んだ内容とのつながり
データ型とデータサイズを理解すると、これまで学習してきた内容がさらに整理できます。
データ型
   ↓
データサイズ
   ↓
メモリ上に配置
   ↓
アドレス
   ↓
ポインタ
   ↓
構造体
   ↓
エンディアン
さらにマイコン内部では、
uint32_t
   ↓
32bitデータ
   ↓
ビット演算
   ↓
レジスタ
   ↓
メモリマップドI/O
   ↓
周辺回路
という形でもつながっています。
つまりデータ型は、単なるC/C++の文法ではなく、ソフトウェア上の変数と実際のメモリやハードウェアをつなぐ重要な基礎です。
まとめ
C/C++のデータ型は、変数がどのようなデータを扱うのかを決める重要な仕組みです。
- データ型によって扱える値や用途が異なる
- データ型にはそれぞれメモリ上のサイズがある
sizeof()で実際のサイズを確認できるintが必ず4バイトとは限らない- 符号あり整数は負の値を扱える
- 符号なし整数は0以上の値を扱う
uint8_tなどの固定幅整数型はデータ幅を明確にできる- 組み込み開発ではレジスタや通信データの幅に合わせた型がよく使われる
- 構造体ではパディングによって単純なメンバサイズの合計と一致しない場合がある
- 必要以上に大きい型・小さい型を選ぶのではなく用途に合わせることが重要
特に組み込み開発では、uint8_t、uint16_t、uint32_tといった型が頻繁に登場します。
「この変数は何を表しているのか」だけでなく、「何ビットのデータなのか」「メモリを何バイト使うのか」まで意識できるようになると、レジスタや通信処理、ライブラリのコードも読みやすくなります。
