
前回の記事では、複数のデータをまとめて扱う構造体(struct)について解説しました。
その中で、構造体を通信データとして扱う場合にはエンディアンに注意する必要がある、と説明しました。
エンディアンとは、16ビットや32ビットなど複数バイトで構成されるデータをメモリ上にどの順番で並べるかを表す方式です。
普段Arduinoでプログラムを書いているだけなら、エンディアンを意識する機会はそれほど多くありません。
しかし、I2C・SPI・UARTなどでバイト列を扱ったり、通信プロトコルを実装したり、バイナリファイルやレジスタのデータを解析したりすると、エンディアンの知識が必要になります。
この記事では、エンディアンとは何か、リトルエンディアンとビッグエンディアンでは何が違うのかを、実際のメモリ配置を見ながら解説します。
エンディアンとは?
エンディアン(Endianness)とは、複数バイトで構成されるデータをメモリ上へ格納するときのバイトの並び順です。
代表的な方式には、次の2種類があります。
- リトルエンディアン(Little Endian)
- ビッグエンディアン(Big Endian)
たとえば、32ビットの値0x12345678を考えてみましょう。
32ビットは4バイトなので、この値は次の4つのバイトに分けられます。
0x12 0x34 0x56 0x78
この4バイトをメモリ上へどの順番で配置するのかが、エンディアンによって異なります。
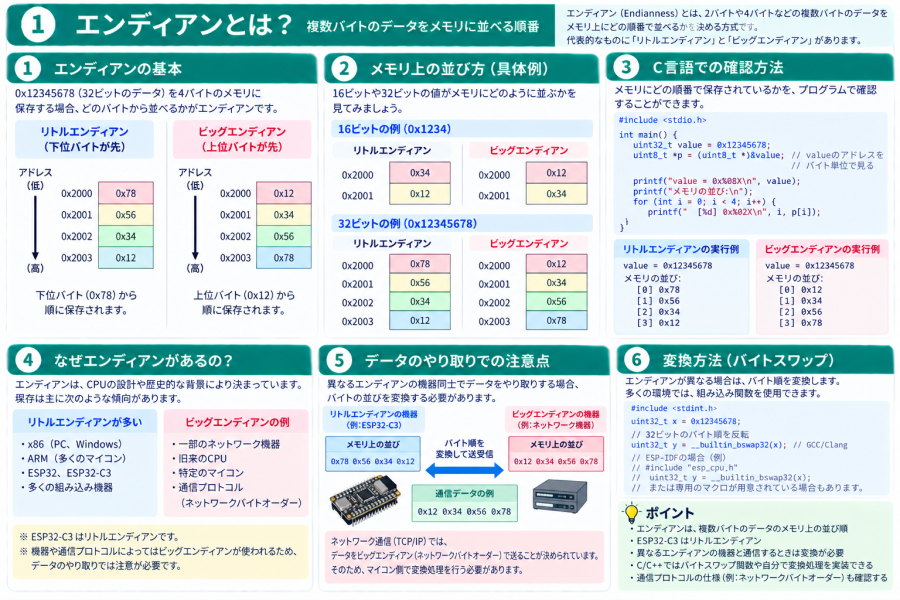
上図のように、同じ0x12345678という値でも、メモリ上に並ぶバイトの順番が異なります。
そもそも1バイトとは?
エンディアンを理解するには、まず「バイト」を整理しておきましょう。
一般的なマイコン環境では、1バイトは8ビットとして扱われます。
1 byte = 8 bit
そのため、16ビットのデータは2バイト、32ビットのデータは4バイトになります。
| データ幅 | バイト数 |
|---|---|
| 8ビット | 1バイト |
| 16ビット | 2バイト |
| 32ビット | 4バイト |
| 64ビット | 8バイト |
リトルエンディアンとは?
リトルエンディアンでは、数値の下位バイトを低いアドレス側へ配置します。
たとえば、次の32ビット値を考えます。
0x12345678
4つのバイトに分けると、
0x12  0x34  0x56  0x78
 ↑                 ↑
上位               下位
となります。
リトルエンディアンでは、メモリ上には次のように配置されます。
アドレス      データ

0x2000       0x78
0x2001       0x56
0x2002       0x34
0x2003       0x12
一番小さいアドレス0x2000に、下位バイトの0x78が格納されています。
ビッグエンディアンとは?
ビッグエンディアンでは、数値の上位バイトを低いアドレス側へ配置します。
同じ0x12345678なら、次のようになります。
アドレス      データ

0x2000       0x12
0x2001       0x34
0x2002       0x56
0x2003       0x78
数値を左から読んだときの順番とメモリ上の順番が同じように見えるため、初めて見る場合はこちらの方が直感的に感じるかもしれません。
リトルエンディアンとビッグエンディアンを比較
0x12345678を例に、2つを並べてみましょう。
| アドレス | リトルエンディアン | ビッグエンディアン |
|---|---|---|
| 0x2000 | 0x78 | 0x12 |
| 0x2001 | 0x56 | 0x34 |
| 0x2002 | 0x34 | 0x56 |
| 0x2003 | 0x12 | 0x78 |
覚え方としては、次のように考えると分かりやすいでしょう。
- リトルエンディアン → 下位バイトから格納
- ビッグエンディアン → 上位バイトから格納
16ビットの場合はどうなる?
16ビットの値でも考え方は同じです。
たとえば、
0x1234
という16ビット値は、
0x12 0x34
の2バイトに分けられます。
| アドレス | リトルエンディアン | ビッグエンディアン |
|---|---|---|
| 0x2000 | 0x34 | 0x12 |
| 0x2001 | 0x12 | 0x34 |
8ビットのデータにもエンディアンはある?
1バイトだけのデータでは、バイトの並び順を入れ替える余地がありません。
たとえばuint8_tの値0x12は1バイトだけなので、リトルエンディアンでもビッグエンディアンでもバイト列は同じです。
エンディアンが問題になるのは、主に2バイト以上の値をバイト単位で扱うときです。
C/C++でメモリ上の並びを確認してみよう
ポインタを使うと、実際にメモリへどのような順番で保存されているのか確認できます。
#include <stdint.h>
#include <stdio.h>

int main(void)
{
    uint32_t value = 0x12345678;

    uint8_t *p = (uint8_t *)&value;

    for (int i = 0; i < 4; i++) {
        printf("%02X\n", p[i]);
    }

    return 0;
}
リトルエンディアンの環境であれば、概念的には次の順番で表示されます。
78
56
34
12
前回学習したポインタを使って、32ビットの変数を1バイトずつ確認しているわけです。
ポインタについては「ポインタとは?アドレス・&・*の意味を初心者向けに解説」で詳しく解説しています。
エンディアンはCPUによって異なる
どのエンディアンを使用するかは、CPUアーキテクチャやシステムの仕様などによって異なります。
現在よく使われるPCや多くのマイコンでは、リトルエンディアンが広く使われています。
ただし、通信プロトコルやファイルフォーマットなどではビッグエンディアンが指定されている場合もあります。
そのため、「自分のCPUがリトルエンディアンだから、受信データもそのまま読める」とは限りません。
ESP32-C3はリトルエンディアン
KUMITATE-C3に搭載されているESP32-C3では、通常リトルエンディアンとしてデータを扱います。
そのため、たとえば32ビット値0x12345678をメモリ上で1バイトずつ確認すると、低いアドレス側から78 56 34 12という並びになります。
ただし、ESP32-C3がリトルエンディアンであることと、I2C・SPI・ネットワークなどで受け取るデータのバイト順は別の問題です。
通信相手やプロトコルがどのバイト順を定義しているかを確認する必要があります。
センサー通信でもエンディアンが重要
I2CやSPIでセンサーから16ビットの測定値を取得する場合、1バイトずつデータを受信することがあります。
たとえばセンサーから次の2バイトを受信したとします。
0x12
0x34
仕様書に「上位バイト→下位バイトの順で送信」と書かれているなら、16ビット値を作るには次のようにできます。
uint8_t high = 0x12;
uint8_t low  = 0x34;

uint16_t value =
    ((uint16_t)high << 8) | low;
結果は、
0x1234
となります。
ここではCPUのメモリ上の並びを直接利用するのではなく、受信したバイトの意味を仕様書に従って組み立てています。
ビットシフトで組み立てれば分かりやすい
通信データを扱う場合、エンディアンを意識せずに受信バッファをそのまま別の型として解釈するより、バイトを明示的に組み立てる方法が分かりやすい場合があります。
uint16_t value =
    ((uint16_t)data[0] << 8) |
(uint16_t)data[1];このコードなら、data[0]を上位8ビット、data[1]を下位8ビットとして扱うことがコード上でも明確です。
ここでも以前学習したビットシフトとOR演算が使われています。
ビット演算については「ビット演算とは?AND・OR・XOR・NOT・シフト演算を初心者向けに解説」も確認してみてください。
ネットワークバイトオーダーとは?
ネットワーク通信では、異なるCPUを搭載した機器同士がデータをやり取りします。
CPUごとにバイト順が異なると、そのまま数値を送受信した場合に解釈が一致しない可能性があります。
そこで、TCP/IPで扱う一部の数値フィールドではネットワークバイトオーダーとしてビッグエンディアンが使われます。
一方、CPU側で通常使用しているバイト順はホストバイトオーダーと呼ばれます。
CPU内部
ホストバイトオーダー
        ↓
必要に応じて変換
        ↓
ネットワークバイトオーダー
        ↓
      通信
htonl()やntohl()とは?
ネットワークプログラミングでは、ホスト側とネットワーク側のバイト順を変換するために、次のような関数が使われます。
| 関数 | 意味 |
|---|---|
htons() | 16ビット値をHostからNetworkへ変換 |
htonl() | 32ビット値をHostからNetworkへ変換 |
ntohs() | 16ビット値をNetworkからHostへ変換 |
ntohl() | 32ビット値をNetworkからHostへ変換 |
これらを使うことで、CPU側のエンディアンを意識した変換処理を自分で毎回記述する必要を減らせます。
バイトスワップとは?
バイトの並びを反転させる処理をバイトスワップ(Byte Swap)と呼びます。
たとえば32ビット値なら、
変換前

0x12 0x34 0x56 0x78

        ↓

変換後

0x78 0x56 0x34 0x12
のように並びを反転します。
コンパイラやSDKによっては、バイトスワップ用の組み込み関数やマクロが用意されています。
利用できる関数は開発環境によって異なるため、その環境のAPIやヘッダーファイルを確認してください。
構造体をそのまま送信するときに注意
前回の記事で説明した構造体と、エンディアンは密接に関係しています。
struct SensorData {
    uint16_t id;
    uint32_t value;
};この構造体のメモリ内容をそのまま別の機器へ送った場合、送信側と受信側のエンディアンが異なると、idやvalueの解釈が変わる可能性があります。
さらに構造体にはパディングが入る場合もあります。
そのため通信フォーマットでは、構造体をそのまま送るのではなく、
- 各フィールドのサイズ
- 送信する順番
- バイトオーダー
- 符号の有無
などを明確に決めて、バイト列へ変換する方法がよく使われます。
構造体については「構造体とは?C/C++のstructとメンバ・ポインタの使い方を初心者向けに解説」で解説しています。
エンディアンとビット順は別の話
エンディアンを理解するときに注意したいのが、バイト順とビット順を混同しないことです。
エンディアンは基本的に、複数バイトの値について「どのバイトを低いアドレス側へ置くか」という話です。
一方、通信では「MSB first」「LSB first」のように、1バイトやデータ単位の中でどちらのビットから送信するかを指定する場合があります。
この2つは関連して見えますが、別々の仕様として確認する必要があります。
エンディアンを意識する場面
通常の変数計算だけをしているときは、CPUやコンパイラが適切に処理するため、エンディアンを強く意識する必要はありません。
一方、次のような場面では重要になります。
- I2Cセンサーから複数バイトの値を読み出す
- SPIデバイスから16ビット・32ビット値を取得する
- UARTで独自のバイナリプロトコルを作る
- ネットワーク通信を行う
- バイナリファイルを読み書きする
- 通信パケットを解析する
- 構造体や数値をバイト列へ変換する
- レジスタの内容をバイト単位で確認する
KUMITATE-C3で考えてみよう
KUMITATE-C3でI2Cセンサーを使用する場合にも、エンディアンの知識が役立ちます。
たとえばセンサーから2バイトの測定値を受信したときは、ESP32-C3自身のエンディアンだけを見るのではなく、センサーのデータシートに書かれた送信順を確認します。
データシートに「MSB first」や「MSB followed by LSB」などと書かれていれば、それに従って受信したバイトを組み立てます。
uint8_t msb = data[0];
uint8_t lsb = data[1];

uint16_t raw =
    ((uint16_t)msb << 8) | lsb;
こうしたコードが「なぜ8ビット左へシフトしているのか」も、エンディアンとビット演算を理解していれば読みやすくなります。
エンディアンでよくある間違い
- リトルエンディアンを「ビットを逆順にすること」だと思う
- CPUのエンディアンと通信プロトコルのバイト順を同じものとして扱う
- 受信バッファをそのまま別の整数型として解釈する
- 構造体をそのまま通信して、相手側でも同じ配置になると思う
- センサーのデータシートでMSB・LSBの順番を確認しない
特に組み込み開発では、「CPUのメモリ上の並び」と「通信線上を流れるデータの順番」を分けて考えることが重要です。
これまで学んだ内容とのつながり
エンディアンまで理解すると、これまでの記事で学んだ内容がさらに実際の通信処理へつながります。
データ型
   ↓
メモリアドレス
   ↓
ポインタ
   ↓
構造体
   ↓
メモリ上のバイト配置
   ↓
エンディアン
   ↓
通信データへの変換
さらに、受信した複数バイトの値を組み立てるときには、以前学習したビット演算も使います。
I2C / SPI / UART
        ↓
    バイト列
        ↓
   エンディアン
        ↓
    ビット演算
        ↓
16bit / 32bit の値
まとめ
エンディアンは、複数バイトのデータをメモリ上にどの順番で配置するかを表す方式です。
- リトルエンディアンは下位バイトを低いアドレス側へ配置する
- ビッグエンディアンは上位バイトを低いアドレス側へ配置する
- 1バイトだけの値ではバイト順の違いは発生しない
- ESP32-C3では通常リトルエンディアンとして扱う
- CPUのエンディアンと通信データのバイト順は別々に確認する
- センサー通信ではデータシートのMSB・LSBの順番を確認する
- ネットワークではビッグエンディアンのネットワークバイトオーダーが使われる場面がある
- 異なるバイト順のデータは必要に応じて変換する
- 構造体をそのまま通信するとパディングやエンディアンの問題が発生する場合がある
エンディアンは最初は「なぜわざわざ順番が違うの?」と感じるかもしれませんが、0x12345678がメモリ上でどのように4バイトへ分かれるかを理解すれば、それほど難しい概念ではありません。
組み込み開発では、センサー、通信、ファイル、ネットワークなど、バイト列を扱う場面で必ず役立つ基礎知識です。
